

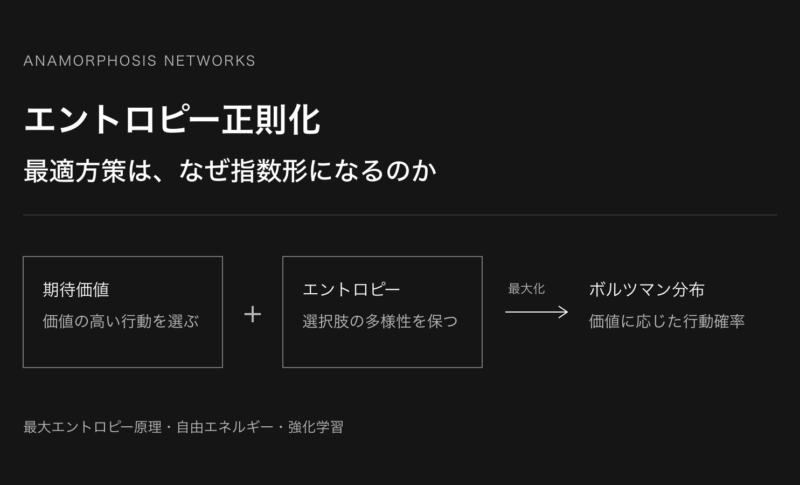
有限個の行動を扱う強化学習で、行動の期待価値に Shannon エントロピーを正の重みで加えると、最適方策はボルツマン分布、すなわち softmax の形になる。統計力学でも、平均エネルギーを制約にしたエントロピー最大化から、同じ指数形の分布が現れる。
この一致は、どこから来るのだろうか。エントロピーは探索のために加えるランダムさなのか。それとも、最小作用の原理のように、解の選び方を決める原理なのか。
答えの中心にあるのは、期待値とエントロピーを組み合わせた変分問題である。何を制約として与え、どの分布を選ぶのか。その構造をたどると、統計力学と強化学習の関係が見えてくる。
エントロピーにも、最小作用のような原理があるのか
「エントロピーにも、最小作用の原理のように解を定める役割があるのではないか」という直感は、変分原理として捉えるなら妥当である。 古典力学では、物理モデルと端点の条件を与え、作用の停留から運動方程式を導く。最大エントロピー原理では、状態空間と既知の情報を与え、その情報と整合する分布の中からエントロピーが最大のものを選ぶ。
ただし、二つの点を区別したい。エントロピーが増えることは、微視的状態のエネルギー準位が下がることを意味しない。また、エントロピー最大化は境界条件そのものではなく、条件を満たす候補から解を選ぶ原理である。
この直感を正確な言葉にすると、「物理モデルと観測事実に基づく制約を与え、その制約のもとで変分原理によって解を定める」となる。最大エントロピーから世界の法則がすべて自動的に出てくるわけではない。何を候補とし、何を既知とするかが、解の物理的な意味を決める。Jaynes(1957)
期待価値とエントロピーを同時に最適化する
まず、ある状態で有限個の行動から一つを選ぶ問題を考える。数式を使う前に、この節の記号を定義しておこう。
| 記号 | 意味 |
|---|---|
| \(s\) | 観測した状態。この節では固定する。 |
| \(\mathcal A\)、\(a\) | \(\mathcal A\) は選択可能な行動の集合、\(a\) はその中の一つの行動。 |
| \(Q\)、\(Q(s,a)\) | \(Q\) は行動の価値を表す関数。\(Q(s,a)\) は状態 \(s\) で行動 \(a\) を取る価値。 |
| \(\pi\)、\(\pi(a\mid s)\) | \(\pi\) は各状態での行動選択の確率分布を定める方策。\(\pi(a\mid s)\) は状態 \(s\) のもとで行動 \(a\) を選ぶ確率。縦線 \(\mid\) は条件づけを表す。 |
この節では、行動価値関数 \(Q\) は与えられたものとして扱う。記号 \(\sum_{a\in\mathcal A}\) は、集合 \(\mathcal A\) に含まれるすべての行動について足し合わせることを表す。方策は、次の確率の条件を満たす。
期待価値だけを最大化するなら、\(Q\) が最大の行動を選べばよい。最大値を取る行動が一つなら、最適方策はその行動を確率 1 で選ぶ。
次に、状態 \(s\) での行動分布の Shannon エントロピーを \(H(\pi)\) と書く。\(H\) は確率分布の広がりを測る関数である。\(\log\) は自然対数とし、確率が 0 の項では \(0\log0=0\) とする。自然対数で表したエントロピーの単位を nat(ナット)と呼ぶ。
エントロピー項の重みを調整する正の係数を \(\alpha\) とする。状態 \(s\) を固定した正則化付きの評価値を \(j_\alpha(\pi;s)\) と書き、次のように定義する。添字 \(\alpha\) は、この評価値が正則化係数に依存することを示す。
右辺の最初の項が期待価値、二つ目がエントロピーに対する評価である。価値の高い行動を選びたい。一方で、特定の行動に確率を集中させすぎるとエントロピーは下がる。係数 \(\alpha\) が、この二つの項の重みを調整する。
導出に入る前に、\(\pi_a=\pi(a\mid s)\)、\(Q_a=Q(s,a)\) と略記する。添字だけの和 \(\sum_a\) も、行動集合全体にわたる和を表す。また、正規化制約に対応するラグランジュ未定乗数を \(\lambda\)、制約を目的関数に組み込んだ補助関数を \(\mathcal L(\pi,\lambda)\) と書く。この補助関数は、
となる。各 \(\pi_a\) で偏微分し、その値が 0 になる停留条件を求めると、
ここで \(\exp\) は自然指数関数、\(\propto\) は比例関係を表す。停留条件を整理すると、\(\pi_a\propto\exp(Q_a/\alpha)\) になる。
評価値を最大にする方策を \(\pi^*\)、その行動 \(a\) の確率を \(\pi_a^*\) と書く。上付きの星印 \(*\) は最適解を示す。分母で使う添字 \(b\) は、\(a\) と同じ行動集合 \(\mathcal A\) を走り、\(Q_b=Q(s,b)\) とする。確率の和が 1 になるように正規化すれば、
を得る。有限の \(Q_a\) と \(\alpha>0\) のもとでは目的関数が厳密に凹なので、この分布が唯一の最大解である。
softmax は、確率を滑らかにするために後から付け足した式ではない。この目的関数を最大化した結果として導かれる。 負のエントロピーを正則化項とする最適化は、指数重みの合計に対数を取る log-sum-exp と softmax に対応する。正則化を変えれば、解の形も変わる。Geist らのマルコフ決定過程(MDP)の正則化理論は、この関係を凸共役の枠組みで整理している。
KL ダイバージェンスで、最適性を確かめる
同じ行動集合上の二つの確率分布を比較する量として、Kullback–Leibler(KL)ダイバージェンスを使う。記号 \(D_{\mathrm{KL}}\) で表し、縦線 \(\Vert\) の左に比較対象、右に基準となる分布を書く。方策 \(\pi\) を最適方策 \(\pi^*\) と比較する場合、その定義は次のとおりである。
比較対象の確率が 0 の項の寄与は 0 とする。また、価値に基づく指数重みの合計を \(Z_Q\) と定義する。添字 \(Q\) は、行動価値から作った正規化定数であることを示す。
最適方策の式から \(\log\pi_a^*=Q_a/\alpha-\log Z_Q\) が得られる。これを KL ダイバージェンスの定義に代入すれば、任意の方策について次の恒等式を確認できる。
KL ダイバージェンスは非負で、0 になるのは両分布が一致するときである。つまり、目的関数の最大値は \(\alpha\log Z_Q\)、そこからの損失は \(\alpha D_{\mathrm{KL}}(\pi\Vert\pi^*)\) に等しい。
統計力学では、平均エネルギーを制約にする
今度は、有限個の微視的状態からなる系を考える。状態を識別する添字を \(i\)、状態 \(i\) のエネルギーを \(E_i\)、その状態にある確率を \(p_i\) とする。確率分布全体を \(p\) と書き、\(\sum_i\) はすべての候補状態についての和を表す。既知の平均エネルギーを \(U_0\) とすると、正規化と平均エネルギーの制約は次のように書ける。
各確率 \(p_i\) は非負とする。行動分布の場合と同様に、\(H(p)=-\sum_i p_i\log p_i\) を、この制約のもとで最大化する。ここでは \(H(p)\) が微視的状態の分布の Shannon エントロピーを表す。
平均エネルギー制約に対応するラグランジュ未定乗数を \(\beta\)、正規化制約に対応する乗数を \(\lambda_E\) とする。これらを使って \(p_i\) に関する停留条件を求めると、
となる。エネルギーに基づく指数重みの合計を \(Z_E\) と呼ぶ。添字 \(E\) はエネルギー側の正規化定数であることを示す。また、分母の添字 \(m\) は、\(i\) と同じ微視的状態の集合を走り、\(E_m\) はその状態のエネルギーを表す。正規化した解は、
になる。\(\beta\) は平均エネルギー制約を満たすように決まる。絶対温度を \(T\)、Boltzmann 定数を \(k_B\) とすると、正温度のカノニカル分布では \(\beta=1/(k_BT)\) であり、これがボルツマン分布である。
Jaynes は、統計力学を部分的な情報から確率分布を推論する問題として捉え、最大エントロピー原理を論じた。ここでいう「余計な仮定を加えない」とは、選んだ状態空間と制約の範囲内で、追加の偏りを導入しないという意味である。何を状態と数えるか、どの情報を制約にするかは、先に決める必要がある。Jaynes(1957)
また、この式は微視的状態の確率を表している。あるエネルギー値を \(E\)、その値を持つ状態の個数を \(g(E)\) と定義すれば、そのエネルギー準位全体の確率は \(g(E)\exp(-\beta E)\) に比例する。エネルギーだけで分布を読むときは、この状態数も効いてくる。
平衡を決めるのは自由エネルギー
「ランダムさがあるほど、状態のエネルギー準位が下がって安定する」と理解すると、異なる量を混同してしまう。ここで固定した物理モデルでは、各状態のエネルギー \(E_i\) は先に決まっている。エントロピー最大化で変えるのは、各状態を占める確率 \(p_i\) である。平均エネルギーを \(U_0\) に固定した前節の問題では、平均エネルギーも下がらない。制約で同じ値に保たれているからである。
温度・体積・粒子数を固定した平衡問題で最小化されるのは、Helmholtz 自由エネルギーである。ここでは、任意の確率分布 \(p\) に対する平均エネルギーを \(U[p]\)、熱力学的エントロピーを \(S[p]\)、自由エネルギーを \(F[p]\) と書く。角括弧は、確率分布全体を引数に取ることを示す。熱力学的エントロピーは Shannon エントロピーに Boltzmann 定数を掛けた量で、\(S[p]=k_BH(p)\) と定義する。
温度 \(T\) における自由エネルギーは、
となる。低い平均エネルギーを選ぶ効果と、大きいエントロピーを選ぶ効果が競合する。温度は、その重みを決める。
同じ温度で分布を比較するなら、温度とエントロピーの積の増加が、平均エネルギーの増加を上回れば、自由エネルギーは下がる。したがって、「エネルギーが低いこと」と「自由エネルギーが低いこと」は同じではない。たとえば、異なるエネルギーを持つ二つの状態だけからなる系では、正の温度を上げると高エネルギー状態の占有確率が増え、平均エネルギーとエントロピーがともに増える。
平衡の条件は、系の置かれた環境にも依存する。エネルギー・体積・粒子数を固定した孤立系では、許される巨視的状態の中で熱力学的エントロピーが最大になることが平衡の基準となる。一定温度の熱浴と接し、体積・粒子数を固定した系では、Helmholtz 自由エネルギーの最小化が対応する基準である。ここでの「安定」は熱力学的な平衡の意味であり、AI 方策や制御系の安定性を保証するものではない。MIT の統計力学の講義資料
固定されたエネルギー \(E_i\) と正の温度 \(T\) に対して、カノニカル平衡分布を \(p_{\mathrm{eq}}\)、その分布での自由エネルギーを \(F_{\mathrm{eq}}=F[p_{\mathrm{eq}}]\) と書く。添字 eq は equilibrium(平衡)を表す。この分布と任意の分布 \(p\) を比較すると、上の式から
も直接確かめられる。平衡分布は、エネルギーだけを最小にする分布ではなく、この自由エネルギーを最小にする分布なのである。
強化学習との対応を見るため、行動 \(a\) に形式的なエネルギー \(E_a\) を割り当て、\(E_a=-Q_a\) と定める。さらに \(k_BT=\alpha\) と置けば、行動分布についての自由エネルギーは、先ほどの評価値 \(j_\alpha(\pi;s)\) の符号を反転したものになる。両者は次のように対応する。
| 統計力学 | 固定した状態での方策最適化 |
|---|---|
| 微視的状態 \(i\) | 行動 \(a\) |
| エネルギー \(E_i\) | 負の価値 \(-Q_a\) |
| 温度に伴うエネルギー尺度 \(k_BT\) | 正則化係数 \(\alpha\) |
| 自由エネルギーの最小化 | 期待価値+エントロピーの最大化 |
| \(F_{\mathrm{eq}}=-k_BT\log Z_E\) | \(j_\alpha(\pi^*;s)=\alpha\log Z_Q\) |
この置き換えのもとでは、数式上は同じ最適化問題になる。ただし、AI の \(\alpha\) が物理的な温度を測っているわけではない。\(\alpha\) は \(Q\) と同じ単位を持つ設計パラメータであり、その意味は報酬の尺度にも依存する。
「温度」を変えると、方策はどう変わるか
ここでは行動を 1、2 の二つに限定する。\(Q_1\)、\(Q_2\) はそれぞれ行動 1、2 の価値、\(\pi_1^*\)、\(\pi_2^*\) はそれぞれを選ぶ最適方策の確率である。\(Q_1=100\)、\(Q_2=99\) として計算すると、次のようになる。これは説明のための数値例である。
| \(\alpha\) | 行動 1 の確率 | 行動 2 の確率 |
|---|---|---|
| 0.2 | 99.33% | 0.67% |
| 1 | 73.11% | 26.89% |
| 5 | 54.98% | 45.02% |
このとき \(\pi_1^*=1/(1+\exp(-1/\alpha))\) であり、確率を決めるのは \(Q_1-Q_2\) と \(\alpha\) の比である。すべての \(Q\) に同じ定数を足しても方策は変わらない。\(Q\) を正の定数倍するなら、同じ方策を保つには \(\alpha\) も同じ倍率で調整する。
有限個の行動では、\(\alpha\to0^+\) で最大価値の行動に確率が集中し、\(\alpha\to\infty\) で一様分布に近づく。最大価値の行動が複数ある場合、前者の極限では、その行動間で一様になる。
最大エントロピー原理は、分布をどう選ぶのか
エントロピーを「乱雑さ」とだけ説明すると、方策最適化で果たしている役割が見えにくい。
たとえば、有限の四つの選択肢で \((1,0,0,0)\) は集中した分布、\((1/4,1/4,1/4,1/4)\) はエントロピーが最大の分布である。最大エントロピー原理は、与えられた制約を満たす分布の中から、必要以上に集中していないものを選ぶ。
ここから、エントロピーを「可能性を一つに絞るとき、その絞り込みに根拠を求める量」と解釈できる。ただし、これは推論原理としての読み方である。強化学習では、エントロピー項を加えることで、最適化の目的自体を変更している。
\(Q_1=100\)、\(Q_2=99\) が正確に分かっており、期待価値だけが目的なら、行動 1 を確率 1 で選ぶのは正しい。その判断が「情報に対して過剰」とは限らない。確率を分散させるのは、エントロピーにも価値を置く設計を採用したからである。エントロピー正則化だけで、\(Q\) の推定誤差や未知性を表現できるわけではない。
基準分布を置くと、何を保ちたいかが明確になる
各行動に一様な確率を与えることが、いつも適切とは限らない。基準として維持したい行動分布を \(\rho\)、その行動 \(a\) の確率を \(\rho_a\) とする。ここではすべての行動について \(\rho_a>0\)、\(\sum_a\rho_a=1\) を仮定する。
\(\max_\pi\) は、確率の条件を満たす方策 \(\pi\) の中で最大値を求める操作を表す。基準分布からの変化に KL ダイバージェンスで費用を課す問題は、
と書ける。この問題での最適方策も \(\pi^*\) と書く。添字 \(b\) を使う場合も、\(\pi_b^*\) は行動 \(b\) の最適な選択確率、\(\rho_b\) は基準分布での選択確率を表す。同じ計算によって、
になる。価値の差に応じて基準分布を更新する、という形である。行動の総数を \(n\) とする。\(\rho\) がその \(n\) 個の行動に対して一様なら、\(D_{\mathrm{KL}}(\pi\Vert\rho)=\log n-H(\pi)\) なので、Shannon エントロピーの正則化と同じ最適方策を得る。
この解の確率比は、
となる。基準方策の選好に、価値差による補正が加わる。これが「理由がある分だけ基準分布から離れる」という解釈の、数式で表された中身である。
なお、すべての \(\rho_a\) が正であるという仮定を外すと、\(\rho_a=0\) の行動に正の確率を与えた場合、KL ダイバージェンスは無限大になる。基準分布を選ぶことは、選択可能な行動の範囲にも関わる。
最小作用の原理と共有する変分構造
古典力学では、軌道に対して作用を定義し、その停留条件から運動方程式を導く。この節では、連続的な時刻を \(t\)、その時刻における位置などの一般化座標を \(q(t)\)、その時間微分である一般化速度を \(\dot q(t)\) とする。考える時間区間の始点と終点を \(t_0\)、\(t_1\) と書く。
力学系を記述する関数であるラグランジアンを \(L(q,\dot q,t)\)、軌道全体に対して定まる作用を \(I[q]\) と書く。関数 \(L\) の引数では、\(q\) と \(\dot q\) は時刻 \(t\) の座標と速度を略記している。典型的な保存系では、ラグランジアンは運動エネルギーからポテンシャルエネルギーを引いた関数である。
積分記号 \(\int_{t_0}^{t_1}\cdots\,dt\) は、時刻 \(t_0\) から \(t_1\) まで時間方向に積み上げる操作を表す。軌道を微小に変えたときの作用の一次変化を \(\delta I\) と定義すれば、作用の定義と停留条件は、
と書ける。微分記号 \(d/dt\) は時間微分、\(\partial\) はほかの引数を固定した偏微分を表す。端点の座標を固定して変分すると、Euler–Lagrange 方程式
が得られる。「最小作用」と呼ばれるが、一般に要求するのは作用の停留であり、必ずしも大域的な最小値ではない。MIT の Hamilton の原理の講義資料
具体的に、一定の質量を持つ粒子が一次元を動く保存系を考える。この例では \(q\) を粒子の位置、\(\dot q\) を速度として使う。粒子の正の質量を \(M\)、位置に依存するポテンシャルエネルギーを \(\Phi(q)\) と定義する。ラグランジアンは、
である。位置の二階時間微分、すなわち加速度を \(\ddot q\)、位置に関するポテンシャルの微分を \(d\Phi/dq\)、粒子に働く力を \(f(q)\) と定義する。このラグランジアンを Euler–Lagrange 方程式に代入すると、
を得る。これが Newton の運動方程式である。運動エネルギーとポテンシャルという物理モデルを与えたうえで、変分原理から運動を定めている。
最大エントロピー原理との共通点は、候補の集合に対して汎関数を定め、制約のもとで変分する構造にある。古典力学では軌道を、最大エントロピーでは確率分布を選ぶ。
| 区別する要素 | 古典力学の例 | 最大エントロピーの例 |
|---|---|---|
| 物理モデル | 質量・ポテンシャルとラグランジアン | 微視的状態の集合と各状態のエネルギー |
| 与える条件 | 時間区間の両端での位置 | 確率の正規化と既知の平均エネルギー |
| 変分原理 | 作用の停留 | エントロピーの最大化 |
| 得られる解 | 運動方程式を満たす軌道 | 制約を満たすボルツマン分布 |
境界条件は、たとえば軌道の端点での位置を指定する条件である。平均エネルギーの指定は分布全体に対する制約であり、これらの条件と選択原理は分けて考える必要がある。\(\sum_i p_iE_i=U_0\) は分布が満たす条件であり、エントロピー最大化は、その条件を満たす候補から分布を選ぶ原理である。
「エントロピー最大化とは、世の中の摂理を境界条件に入れること」という表現は、この区別を曖昧にする。より正確には、モデルと制約が何を候補とするかを定め、変分原理がその中で解を選ぶ。 物理法則や観測事実はモデル・制約の側に与える必要があり、最大エントロピー原理がそれらを代わりに決めるわけではない。この構造の類似だけで、古典力学と最大エントロピーが同一の物理法則になるわけでもない。
軌道の分布を扱う Maximum Caliber
この発想を、状態から軌道へ広げたものが Maximum Caliber(MaxCal)である。まず、観測時刻を表す離散的な番号を \(k\)、最後の時刻番号を非負整数 \(N\) とし、時刻 \(k\) に観測される状態を \(x_k\) とする。一つの軌道を \(\Gamma=(x_0,x_1,\ldots,x_N)\) と定義する。時刻番号には、温度 \(T\) と別の記号を用いている。
候補となる有限の軌道集合を \(\Omega\)、その集合上の確率分布を \(P\) と書く。\(P(\Gamma)\) は軌道 \(\Gamma\) が生じる確率である。MaxCal は、動的な観測量の制約のもとで、軌道分布のエントロピーを最大化する枠組みである。Pressé ら(2013)
軌道から観測量を計算する関数を \(C\)、軌道 \(\Gamma\) での値を \(C(\Gamma)\)、既知の平均値を \(\bar C\) とする。観測量には、たとえば遷移回数などを選べる。確率の正規化に加え、平均値の制約 \(\sum_{\Gamma\in\Omega}P(\Gamma)C(\Gamma)=\bar C\) を課す。
この平均値制約のラグランジュ未定乗数を \(\eta\)、エントロピーを最大化する軌道分布を \(P^*\) と書く。状態分布の場合と同じ導出から、
を得る。最適化の対象が軌道そのものではなく、軌道の確率分布になる点が興味深い。ただし、ここから Newton の運動方程式が無条件に出るわけではない。どの軌道を候補にし、何を観測量や制約とするかに、物理的なモデルが必要になる。
強化学習では、将来のエントロピーも価値に含める
冒頭では、固定した \(Q\) から行動分布を求めた。実際の逐次意思決定では、その行動が次の状態に影響するため、将来も含めて評価する必要がある。
この節でも、\(s\) は状態、\(a\) は行動、\(\pi\) は方策、\(\alpha\) は正の正則化係数を表す。逐次意思決定で新しく必要になる記号を定義しておこう。
| 記号 | 意味 |
|---|---|
| \(k\)、\(s_k\)、\(a_k\) | \(k=0,1,2,\ldots\) は離散時刻の番号。\(s_k\) はその時刻の状態、\(a_k\) はその時刻に選ぶ行動。 |
| \(r(s,a)\) | 状態 \(s\) で行動 \(a\) を選んだときの期待即時報酬。ここでは有界とする。 |
| \(\gamma\) | 将来の評価を一段階ごとに割り引く係数。\(0<\gamma<1\) とする。 |
| \(\mathbb E_\pi\) | 初期状態の分布を固定し、方策 \(\pi\) と環境の状態遷移に従って生じる軌道について平均する期待値演算。 |
| \(\pi(\cdot\mid s_k)\) | 状態 \(s_k\) での行動分布全体。点記号 \(\cdot\) は、特定の行動に限定しないことを示す。 |
状態を固定した冒頭の評価値 \(j_\alpha(\pi;s)\) と区別し、軌道全体についての正則化付き累積評価を \(J_\alpha(\pi)\) と書く。記号 \(\sum_{k=0}^{\infty}\) は、初期時刻から将来のすべての時刻について足し合わせることを表す。その定義は、
である。
最適な soft value を \(V_\alpha^*(s)\) と書く。これは、状態 \(s\) からの報酬とエントロピーを含む累積評価の最大値である。最適な soft Q を \(Q_\alpha^*(s,a)\) と書き、現在の行動 \(a\) を固定した場合の即時報酬と、次状態以降の最適な割引評価を含む値とする。現在の状態でのエントロピーは、soft value の側で加える。
次の状態を \(s’\)、状態 \(s\) と行動 \(a\) を与えたときの次状態分布についての条件付き期待値を \(\mathbb E_{s’\mid s,a}\) と定義する。有限行動の場合、これらの量は次の Bellman 方程式を満たす。
最適方策は、この \(Q_\alpha^*\) の softmax になる。通常の期待報酬だけで学習した \(Q\) を softmax に変換することと、将来のエントロピーも含めた目的を最適化することは、区別する必要がある。
Soft Actor-Critic(SAC)は、この最大エントロピーの目的を用いる代表的な手法である。実用上はニューラルネットワークなどで表現した方策の集合を用い、指数形の目標分布への KL ダイバージェンスを減らす更新を行う。したがって、任意の連続行動空間で厳密なボルツマン分布を、そのまま計算しているという説明は正確ではない。Haarnoja ら(2018)
連続行動では、確率密度の基準となる測度や座標、分配関数の有限性も問題になる。無限に広い行動空間に正規化可能な一様分布は存在しないので、「温度を上げれば一様になる」という説明は、先ほどの有限行動の条件に限定して読む必要がある。
工学的には、目的・基準・制約を設計する
たとえば製造工程の制御で、候補となる運転条件に、品質・処理量・消費電力などを反映した価値を与えるとする。これは応用を考えるための仮想例である。
このとき設計すべきなのは、softmax の式だけではない。何を報酬とするか、既存の運転方策を基準にするか、どの条件を実行可能とするか、そして \(\alpha\) をどの尺度で選ぶかである。
Shannon エントロピーを使うと、許された行動に確率を分散させる。KL 正則化を使えば、基準方策からの変更を抑える。しかし、どちらも設備の上限値や品質条件を自動的に守る仕組みではない。実行可能な行動集合や制約は、現場と設備の条件に基づいて別途定める必要がある。
エントロピー正則化の本質は、最適行動にノイズを加えることだけではない。どの程度まで方策を集中させるかを、目的関数の中で定めることにある。
期待値に Shannon エントロピーを組み合わせれば、ボルツマン分布が現れる。平均エネルギーを制約として与えれば、同じ指数形の平衡分布が現れる。両者をつなぐのは、「世界はランダムさを好む」という説明ではなく、何を既知とし、どの分布を選ぶかを明示した変分問題なのである。
参考文献
- E. T. Jaynes, Information Theory and Statistical Mechanics, Physical Review, 106, 620–630, 1957.
- M. Geist, B. Scherrer, O. Pietquin, A Theory of Regularized Markov Decision Processes, ICML / PMLR 97, 2160–2169, 2019. とくに第 2.2 節、第 3 節、第 4.1 節。
- T. Haarnoja, A. Zhou, P. Abbeel, S. Levine, Soft Actor-Critic: Off-Policy Maximum Entropy Deep Reinforcement Learning with a Stochastic Actor, ICML / PMLR 80, 1861–1870, 2018. とくに第 3.2 節、第 4.1 節。
- S. Pressé, K. Ghosh, J. Lee, K. A. Dill, Principles of maximum entropy and maximum caliber in statistical physics, Reviews of Modern Physics, 85, 1115–1141, 2013.
- MIT, Hamilton’s Principle — Lecture 4.
- MIT OpenCourseWare, 3.012 Fundamentals of Materials Science — Lecture 22: Systems with Fixed Temperature. とくに第 5–6 ページ。
