熟練者が製造ラインの送り速度を落としたとき、その理由は何でしょうか。品質の悪化を避けたいのか、設備停止のリスクを抑えたいのか、それとも後工程の滞留を解消したいのか。操作履歴だけを見ても、判断の目的が一つに定まるとは限りません。
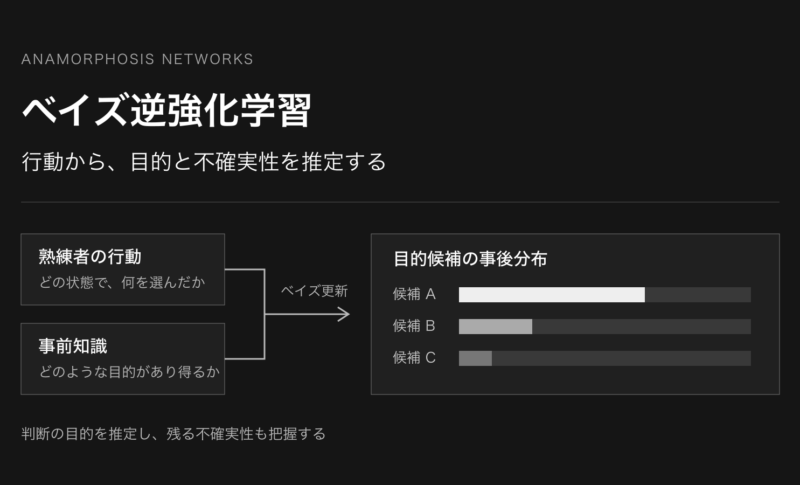
逆強化学習(Inverse Reinforcement Learning:IRL)は、行動を説明する報酬関数を推定する問題です。ベイズ逆強化学習(Bayesian IRL:BIRL)は、その報酬を一つの答えに絞らず、候補のもっともらしさを事後分布として表します。
本記事では、BIRLの確率モデルを数式で確認し、最大エントロピーIRL、模倣学習、観測からの学習との関係を整理します。そのうえで、2024〜2025年の代表研究と製造工程への応用を考えます。
1. 強化学習は方策を求め、逆強化学習は報酬を推定する
報酬とは、結果をどのように評価するかを数値で表したものです。方策とは、状態に応じて行動を選ぶ規則です。強化学習(Reinforcement Learning:RL)では評価基準を与え、その基準に沿ってよい行動を学びます。IRLでは熟練者の行動を手がかりに、評価基準の側を推定します。
まず、本記事で使う記号を定義します。基本モデルは、状態と行動が有限個ある、割引付きマルコフ決定過程(MDP)です。
| 記号 | 定義 |
|---|---|
| \(S\)、\(A\) | 状態の集合、行動の集合。基本モデルでは全状態で同じ行動集合を使う |
| \(s\)、\(a\)、\(s’\) | 現在の状態、選ぶ行動、次の状態 |
| \(P(s’\mid s,a)\) | 状態 \(s\) で行動 \(a\) を選んだとき、次の状態が \(s’\) になる確率 |
| \(\rho\) | 初期状態の確率分布 |
| \(\gamma\) | 将来の報酬の重みを減衰させる割引率。\(0\leq\gamma<1\) |
| \(R(s,a)\) | 状態・行動に対応する報酬。各候補に共通の上限・下限を持つ実数値で、正負の評価を含む |
| \(\pi(a\mid s)\)、\(\pi_E\) | 方策による行動選択確率、およびエキスパートの方策。添字 \(E\) はエキスパートを表す |
| \(t\)、\(s_t\)、\(a_t\) | 時刻を表す非負整数と、その時刻の状態・行動 |
| \(\mathbb E_\pi[\cdot]\) | 初期分布 \(\rho\)、遷移 \(P\)、方策 \(\pi\) から生じる軌跡に関する期待値 |
| \(J_R(\pi)\) | 報酬 \(R\) のもとで方策 \(\pi\) を使ったときの期待割引累積報酬 |
縦線 \(\mid\) は条件付き、\(\sum\) は指定した範囲の和を表します。\(\gamma^t\) は割引率の \(t\) 乗です。これらの定義により、方策の評価値は次のように書けます。
ここでは \(P\)、\(\rho\)、\(\gamma\) を既知かつ固定とします。強化学習は、与えられた \(R\) に対してこの評価値を最大化する方策を求めます。IRLは、エキスパートの実演を説明する \(R\) を推定します。遷移も未知の場合は、環境の推定と報酬の推定を区別して扱う必要があります。
関連する用語は、同じ階層の手法名として並べると混乱します。
| 用語 | 何を表すか |
|---|---|
| IRL | 実演から報酬を推定する問題 |
| BIRL | IRLをベイズ推論として扱う方法 |
| Reward Learning(報酬学習) | 行動、二者比較、評価などから報酬を学ぶ、より広い目的 |
| Apprenticeship Learning | 実演を利用して、エキスパートに近いタスク性能を持つ方策を獲得する目的 |
| Imitation Learning(模倣学習) | エキスパートの振る舞いを学ぶ枠組み。行動を直接学ぶBehavioral Cloningなどを含む |
| Learning from Observation(LfO) | エキスパートの操作入力・行動ラベルを観測できないというデータ条件 |
同じIRLでも、報酬そのものを分析したい場合と、推定した報酬を介して方策を学びたい場合があります。この利用目的の区別は、2007年のBIRL論文でも扱われています。Ramachandran & Amir(2007)
2. BIRLは、報酬候補を行動データで更新する
事前分布・尤度・事後分布
実演データを \(D\) とします。本節では、状態・行動とエピソードの区切りが記録された軌跡データを使います。観測された操作の総数を正整数 \(N\)、各操作の状態・行動を \((s_i,a_i)\) とし、\(i\) は \(1\) から \(N\) までの記録番号です。
有限の状態・行動集合では、報酬関数 \(R\) は各組み合わせの報酬を並べたベクトルとして扱えます。以下の \(p\) は、離散候補なら確率、連続パラメータなら確率密度を表します。
- \(p(R)\):実演を見る前に、どの報酬候補をどの程度もっともらしいと考えるかを表す事前分布。
- \(p(D\mid R)\):報酬候補 \(R\) のもとで、その実演が生じるもっともらしさを表す尤度。
- \(p(R\mid D)\):実演を観測した後の報酬候補の事後分布。
- \(p(D)\):事後分布全体を正規化するための、データの周辺確率。以下では正であるとします。
ベイズの定理により、
となります。事前分布には、品質を悪化させる結果には負の評価を与える、といった仮定を入れられます。ただし、データだけでは区別できない候補については、事前分布の影響が残ります。事後確率は、採用したモデルと仮定のもとでの確信度です。
行動を説明するボルツマン型モデル
報酬候補 \(R\) のもとで、状態 \(s\) から最初に行動 \(a\) を取り、その後は期待累積報酬を最大化する場合の行動価値を \(Q_R^*(s,a)\) と定義します。添字 \(R\) は使う報酬、上付き \(*\) は最適な継続方策を表します。ここでの価値には、将来のエントロピー報酬を加えていません。
また、\(\beta>0\) を行動選択の鋭さを決める係数、\(b\) を分母で全行動を数え上げるための変数とします。\(\beta Q_R^*\) は無次元になるように尺度を合わせます。\(\exp\) は指数関数、\(\sum_{b\in A}\) は行動集合 \(A\) 全体で和を取る操作です。報酬候補に対応するエキスパートの行動モデルを \(\pi_R\) と書くと、正規化したボルツマン型モデルは、
です。このモデルでは価値の高い行動ほど選ばれやすくなります。\(\beta\) をゼロに近づけると行動確率は一様に近づき、大きくすると最大価値の行動に集中します。同じ最大値を持つ行動が複数あれば、それらに確率が分かれます。
\(\beta\) は「合理性パラメータ」と呼ばれることもありますが、人間の熟練度をそのまま測る指標ではありません。観測されていない制約や、価値モデルの誤りでも行動のばらつきは生じます。さらに、報酬の尺度と \(\beta\) を同時に自由にすると、両者を区別しにくくなります。
軌跡の尤度を作る
エキスパートが状態だけに基づく定常マルコフ方策 \(\pi_R\) を使い、初期分布と遷移が \(R\) に依存しないと仮定します。軌跡全体の確率には、行動確率に加えて初期状態・状態遷移の確率が含まれます。\(\prod_{i=1}^{N}\) は、記録番号 \(1\) から \(N\) までの値をすべて掛け合わせる操作です。このうち報酬候補によらない因子を省くと、記号 \(\propto\) を「報酬候補によらない係数を除いて比例する」の意味で使って、
と書けます。したがって、
です。この積はマルコフモデルによる軌跡の因数分解から生じます。操作履歴が無条件に独立だと主張しているわけではありません。
計算では報酬候補を変えるたびに、その候補に対応する最適価値を求めて行動の尤度を評価します。2007年の論文は、報酬空間を探索するMCMC法「PolicyWalk」を提案しました。MCMCは、候補の更新を繰り返し、目的の確率分布を近似するサンプリング法です。原論文は状態のみに依存する報酬を使っています。本記事の状態・行動報酬は、考え方を説明するための拡張した記法です。BIRL原論文
3. 一回の操作で、目的に対する確信はどう変わるか
仕組みを見るため、一回の操作で終了する仮想問題を考えます。行動は「減速」「速度維持」の二つ、報酬候補は「品質重視」「生産量重視」の二つだけです。\(\beta=1\) とし、各候補の行動価値を次のように仮定します。実際の工場の測定値ではありません。
| 報酬候補 | 減速の行動価値 | 速度維持の行動価値 | 減速を選ぶ確率 |
|---|---|---|---|
| 品質重視 | 2 | 0 | 約88.08% |
| 生産量重視 | 0 | 2 | 約11.92% |
事前確率は両候補とも50%とします。「減速」を一回観測すると、ベイズの定理により、品質重視の事後確率は約88.08%になります。同じ状態から独立に開始した二回の実演で、どちらも減速が選ばれた場合は約98.20%です。
品質重視 50.00%
生産量重視 50.00%
品質重視 88.08%
生産量重視 11.92%
品質重視 98.20%
生産量重視 1.80%
この例で更新したのは、どちらの目的がもっともらしいかという確率です。エキスパートが減速を選ぶ確率とは、対象が異なります。また、候補や係数を変えれば結果も変わります。少数の観測で高い確率が出ても、現場の目的を特定できたと判断するにはモデルの検証が必要です。
4. 報酬を分析することと、方策を獲得することを分ける
報酬を代表値で表したい場合
\(\mathbb E_{R\mid D}[\cdot]\) を報酬の事後分布に関する期待値、\(\bar R(s,a)\) を事後平均報酬と定義します。
報酬ベクトルの二乗誤差を損失とする場合、事後平均は期待損失を最小化します。一方、事後確率密度が最大となる候補を選ぶMAP推定もあります。MAPはMaximum A Posterioriの略です。多峰性の事後分布では、平均値がどの峰にも近くないことがあるため、代表値に加えて分布を確認することが有用です。
期待累積報酬を最大化したい場合
遷移・初期分布・割引率を固定し、方策も報酬候補に依存させず評価します。この条件では評価値が報酬に線形なので、
が成り立ちます。つまり、実行する方策を一つ選び、事後平均での期待累積報酬を最大化する目的なら、平均報酬で通常の計画・強化学習を行えます。
ただし、最悪ケース、下方リスク、報酬のばらつきを評価する目的には、平均だけでは情報が不足します。実行中の観測で信念を更新し、情報を得るための行動まで最適化する場合も、一般には平均報酬の固定モデルでは扱いきれません。事後分布のどの情報を使うかは、意思決定の目的に応じて決まります。
真の報酬を復元しなくても、よい方策は学べる
AbbeelとNgのApprenticeship Learningは、エキスパートに近い特徴量の累積期待値を持つ方策を学ぶことで、未知の報酬のもとでの性能差を抑える考え方を示しました。Abbeel & Ng(2004)
ここでは正整数 \(K\) を特徴量の数、\(\phi(s,a)\) を \(K\) 次元の有界な特徴量ベクトル、\(w\) を同じ次元の報酬重みとします。\(\top\) は転置で、\(w^\top\phi(s,a)\) は二つのベクトルの内積です。報酬を次の線形モデルで表します。
方策 \(\pi\) による割引特徴量期待値をベクトル \(\mu^\pi\) と定義すると、
\(B>0\) を重みの大きさの上限、\(\epsilon\geq0\) を特徴量期待値の差の上限とします。\(\|\cdot\|_2\) はユークリッドノルム、\(|\cdot|\) は実数の絶対値です。\(\|w\|_2\leq B\) かつ \(\|\mu^\pi-\mu^{\pi_E}\|_2\leq\epsilon\) なら、コーシー・シュワルツの不等式から、
です。これは線形報酬・重みの上限などの仮定のもとで成り立つ性能差の評価です。実演から推定した特徴量期待値には、さらに標本誤差を考慮する必要があります。報酬を完全に復元することと、タスクで十分な性能を得ることは、別の達成目標です。
5. 報酬の不確実性と、行動の多様性は異なる
BIRLと最大エントロピーIRLには指数関数が現れますが、それだけで同じ方法とはいえません。まず、何に確率分布を置いているかを分けて考えます。
| 観点 | BIRL | 最大エントロピーIRL |
|---|---|---|
| 中心となる分布 | 実演を見た後の報酬候補の分布 | 報酬候補に対応する行動・軌跡の分布 |
| 基本的な操作 | 事前分布を尤度で更新する | 制約を満たす行動モデルにエントロピー原理を適用する |
| 表すもの | 目的の推定に関する不確実性 | 同じ目的のもとでの行動の多様性 |
最大エントロピーIRLの軌跡モデル
指数型の分布を見るため、この小節だけは有限長・非割引の軌跡を考えます。正整数 \(T\) を操作回数、\(\tau=(s_0,a_0,\ldots,s_{T-1},a_{T-1},s_T)\) を軌跡、\(\mathcal T\) を許容される軌跡の有限集合とします。\(p_0(\tau)\) は基準となる軌跡分布、\(\alpha>0\) はエントロピー正則化の強さです。
\(G_R(\tau)\) を軌跡の累積報酬として定義します。
正規化定数を \(Z_R\)、その和を取る候補軌跡を \(\tau’\) とすると、基準分布に対する最大エントロピー型モデルは次の形になります。
これは、有限の軌跡集合上の指数型分布を説明する式です。確率的な環境では、軌跡全体を重み付けすることで環境側の遷移確率まで変わった分布になり得ます。したがって、任意の確率的環境で、この分布をそのまま実行可能な方策とみなすことはできません。最大エントロピーIRL(2008)
最大因果エントロピーとの関係
逐次的な意思決定では、その時点までに得られた情報から行動を選ぶ必要があります。最大因果エントロピーは、この情報の順序と環境との相互作用を扱います。Ziebartら(2010)
ここで注意したいのが、行動価値の定義です。2007年BIRLのボルツマン型尤度は、通常の最適累積報酬に基づく \(Q_R^*\) を使います。エントロピー正則化付き制御では、将来のエントロピーまで含むソフト価値を使います。同じソフトマックスの形でも、入力する価値の定義が異なれば、同じ行動モデルにはなりません。
一方、最大因果エントロピーに基づく行動モデルを尤度として選び、報酬をベイズ推定することは可能です。BIRLは推論の枠組み、エントロピー原理は行動モデルを設計する原理として組み合わせられます。
正則化から指数形の最適方策が導かれる理由は、関連記事「エントロピー正則化で、なぜ方策はボルツマン分布になるのか」で説明しています。
6. データを増やしても、識別できない報酬がある
IRLの曖昧さには、サンプル不足だけでは解消しないものがあります。同じ行動を説明する報酬候補が、モデル上、区別できない場合です。
例として、ポテンシャルに基づく報酬整形を考えます。\(\Phi(s)\) を状態ごとに定めた有界な実数値のポテンシャル関数、\(R(s,a,s’)\) を状態遷移ごとの報酬、\(R'(s,a,s’)\) を変換後の報酬と定義します。本節では、報酬の引数を次状態まで含めて拡張しています。
無限時間・割引付きの設定でポテンシャルが有界なら、追加した項の割引累積和は、初期状態だけに依存する定数になります。行動による順位が変わらないため、最適方策も維持されます。有限時間や終端を持つ問題では、終端のポテンシャルなどの境界条件に注意が必要です。Ng・Harada・Russell(1999)
通常の最適行動価値も、同じ状態の全行動に対して同じ定数だけずれます。そのため、固定した \(\beta\) のボルツマン型行動モデルでも、この変換を区別できない場合があります。一方、報酬を正の定数倍する変換は最適方策を維持しても、\(\beta\) を固定した行動確率を一般には変えます。何が識別できないかは、観測対象と行動モデルによって変わります。
区別できない候補をベイズ更新しても、データから候補間の相対的な確信は変わりません。BIRLは推定の曖昧さを表現しますが、観測に存在しない情報を作り出すものではありません。
7. 動画しかない場合は、観測からの学習を考える
熟練者の作業動画はあっても、モーターへの指令や装置への操作入力が記録されていないことがあります。こうしたエキスパートの行動ラベルがない設定が、Learning from Observation(LfO)です。
動画から状態遷移を読み取り、どの操作がその変化を起こしたのかを逆ダイナミクスモデルで推定する方法や、状態遷移の分布を直接学ぶ方法があります。Behavioral Cloning from Observationでは、学習者自身の状態・行動データから逆ダイナミクスを学び、エキスパートの欠けた行動を推定します。エキスパートの行動が観測できないことは、学習者自身も行動データを取得できないという意味ではありません。Torabiら(2018)
また、LfOは報酬を状態だけの関数に制限する条件ではありません。操作コストを含む報酬でも、エキスパートの行動が記録されていなければLfOの設定になり得ます。ただし、映像から設備状態を十分に復元できるか、エキスパートと学習者の設備・動作条件が同じかを、別途確認する必要があります。
8. 2024〜2025年の代表研究が扱う四つの課題
近年の関連研究は、報酬推定の計算負荷、データのカバレッジ、実演者の違い、識別可能性を掘り下げています。以下はBIRLに直接関係する手法と、より広いIRLの研究を分けて選んだ代表例です。
| 研究・発表年 | 扱う課題と提案 | BIRLとの位置づけ |
|---|---|---|
| ValueWalk(UAI 2024) | 報酬候補ごとに計画問題を解く負荷を減らすため、主に行動価値の空間でサンプリングし、報酬へ逆変換する。勾配を利用するMCMC法であるHamiltonian Monte Carloを扱う | ベイズIRLの事後推論を効率化する研究。論文では複数のタスクで計算上の利点を評価 |
| Offline Inverse Reinforcement Learning(ICML 2024) | 追加の環境探索ができないオフライン設定で、実演と整合する報酬集合を推定する。データが覆わない状態・行動の不確実性を扱う | 報酬候補の集合を扱うIRL理論。候補への事後確率を求めるBIRLとは区別する |
| IRLEED(AAAI 2025) | 複数の実演者の熟練度が未知で、判断の偏りや行動のばらつきが異なる状況をモデル化する | 実演者ごとの違いを考慮する、最大エントロピー系IRLの研究 |
| 非指数割引下の部分識別可能性(AAAI 2025) | 双曲割引など、通常の指数割引とは異なる選好のもとで、行動から報酬や意思決定をどこまで復元できるかを分析する | 非指数割引に関する理論。報酬の識別不能性が、方策の復元に及ぼす影響を扱う |
たとえば、ログに含まれない操作の結果まで知りたいなら、オフラインデータのカバレッジが問題になります。複数の作業者の履歴を一緒に使うなら、作業者ごとの判断や熟練度の違いを無視できません。推定手法を選ぶ前に、どの不確実性を扱う必要があるかを定めることが重要です。
9. 選好学習(Preference Learning)は、実演とは異なる情報から報酬を学ぶ
目的を知る手がかりは、実際の操作だけではありません。二つの動作結果を見せて「どちらが望ましいか」を尋ねる二者比較も、報酬学習に使えます。人間の比較評価から報酬モデルを学び、その報酬で強化学習する研究は、RLHF(人間のフィードバックによる強化学習)につながる重要な流れです。Christianoら(2017)
比較する二つの有限軌跡を \(\tau_A\)、\(\tau_B\) とし、添字 \(A\)、\(B\) は比較対象のラベルです。\(\tau_A\succ\tau_B\) は「AをBより好む」という観測を表します。第5節で定義した \(G_R\) を比較のスコアに使い、\(\eta>0\) を選好の鋭さを決める係数とします。実数 \(x\) を受け取るロジスティック関数を \(\sigma(x)=1/(1+\exp(-x))\) と定義すると、Bradley–Terry型のモデルは、
と書けます。この尤度と事前分布を組み合わせれば、比較データに基づくベイズ的な報酬推定になります。
DPO(Direct Preference Optimization)は、明示的な報酬モデルの学習を経由せず、選好データから方策を直接最適化する方法です。KL正則化付きの報酬最大化との関係を利用しますが、報酬の事後分布を求めるBIRLとは推定対象が異なります。Rafailovら(NeurIPS 2023)
10. 製造工程では、評価指標と操作制約を先に設計する
ここからは製造工程への適用を考えるための仮想例です。特定の設備での導入実績や、性能を示すものではありません。
| モデルの要素 | 設計例 |
|---|---|
| 状態 | 温度、設備負荷、仕掛品滞留量、直近の品質指標 |
| 行動 | 送り速度変更、温度設定変更、停止・再開の判断 |
| 実演 | 操作時刻と操作者を含む状態・操作・次状態の履歴 |
| 評価 | 良品生産量、品質ロス、停止時間、消費電力量 |
| 制約 | 設備の許容範囲、安全インターロック、品質上の禁止条件 |
一操作区間について、\(g(s,a,s’)\) を良品生産量、\(\ell(s,a,s’)\) を品質ロス、\(d(s,a,s’)\) を停止時間、\(e(s,a,s’)\) を消費電力量と定義します。各指標は、事前に定めた基準で無次元化・尺度調整した値とします。
報酬重みのベクトルを \(\theta=(\theta_g,\theta_\ell,\theta_d,\theta_e)\) とし、各成分は非負の評価重み、添字は対応する指標を表します。\(R_\theta\) はその重みで構成する遷移報酬です。
このモデルでは、操作履歴から \(p(\theta\mid D)\)、すなわち評価重みの事後分布を求めることが目標になります。\(\beta\) との尺度の混同を避けるため、重みを正規化する、\(\beta\) を固定するなど、識別のための条件を定めます。
実装では、次の順序でモデルの妥当性を確認します。
- 判断時点の情報をそろえる。 作業者が見ていた計測値、アラーム、後工程の状態を記録し、推定モデルの状態と対応させる。
- 選べた操作を特定する。 禁止されていた操作や社内ルールによる行動を、作業者の好みと混同しない。状態ごとの実行可能な行動集合をモデルに反映する。
- 操作の結果を評価できるようにする。 状態遷移モデルやシミュレーターの誤差を確認し、品質の遅れや設備条件の変化を扱う。
- 説明力を確かめる。 学習に使わない操作履歴で行動予測を評価し、作業者への確認や二者比較で、複数の報酬仮説を検証する。
- 制御に使う前に検証する。 安全条件は独立した制約として維持し、オフライン評価と限定した試験で、新しい方策の品質・生産性を確認する。
画像認識で得た品質・状態の指標を、操作履歴や設備データと結び付ければ、熟練者の判断を数理モデルとして検討できます。その際にBIRLが提供するのは、推定した目的と、モデル上で残る不確実性です。設備の安全性や制御性能は、それぞれ別の検証で確かめる必要があります。
理解の軸になる三つの区別
- 報酬の復元と、方策の獲得。 目的を完全に特定できなくても、仮定の範囲でエキスパートに近い性能を得られる場合があります。
- 行動の多様性と、目的に関する不確実性。 行動モデルの確率と、報酬候補の事後確率は、異なる対象を表します。
- データ不足と、原理的な識別不能性。 操作履歴を増やすことで解消する曖昧さと、別の観測・仮定が必要な曖昧さを分ける必要があります。
BIRLを実務で使うためには、最初に「何を推定し、その結果で何を決めたいか」を定めることが出発点になります。
参考文献
以下は本文で参照した原論文と、著者・学会による論文ページです。
- Ramachandran, D. & Amir, E.(2007). Bayesian Inverse Reinforcement Learning. IJCAI.
- Abbeel, P. & Ng, A. Y.(2004). Apprenticeship Learning via Inverse Reinforcement Learning. ICML.
- Ziebart, B. D. et al.(2008). Maximum Entropy Inverse Reinforcement Learning. AAAI.
- Ziebart, B. D., Bagnell, J. A. & Dey, A. K.(2010). Modeling Interaction via the Principle of Maximum Causal Entropy. ICML.
- Ng, A. Y., Harada, D. & Russell, S.(1999). Policy Invariance Under Reward Transformations: Theory and Application to Reward Shaping. ICML.
- Torabi, F., Warnell, G. & Stone, P.(2018). Behavioral Cloning from Observation. IJCAI.
- Bajgar, O. et al.(2024). Walking the Values in Bayesian Inverse Reinforcement Learning. UAI.
- Lazzati, F., Mutti, M. & Metelli, A. M.(2024). Offline Inverse RL: New Solution Concepts and Provably Efficient Algorithms. ICML.
- Beliaev, M. & Pedarsani, R.(2025). Inverse Reinforcement Learning by Estimating Expertise of Demonstrators. AAAI.
- Skalse, J. M. V. & Abate, A.(2025). Partial Identifiability in Inverse Reinforcement Learning for Agents with Non-Exponential Discounting. AAAI.
- Christiano, P. F. et al.(2017). Deep Reinforcement Learning from Human Preferences. NeurIPS.
- Rafailov, R. et al.(2023). Direct Preference Optimization: Your Language Model is Secretly a Reward Model. NeurIPS.
