

文章の前後関係、画像の離れた領域、設備データの時間的な変化。これらを扱うには、一つの入力だけでなく、ほかの入力との関係を計算する必要があります。
Transformerは、Attention(注意機構)による位置間の情報集約と、各位置の特徴変換を組み合わせたニューラルネットワークの構造です。 大規模言語モデル(Large Language Model:LLM)の基盤として知られていますが、画像認識にも使われています。Transformerという構造と、文章生成という用途は分けて捉えると理解が進みます。
この記事では、基本となるSelf-Attention(自己注意)の計算を、記号の定義と数値例から説明します。2017年の原論文を基準に、後続研究で変更された部分も区別します。数値例と図は説明用に作成したもので、学習済みモデルの測定結果ではありません。
1. トークンと入力の表現
Transformerでは、入力をトークンと呼ぶ単位に分け、数値ベクトルで表します。文章の場合、トークンは単語と一致するとは限りません。単語の一部、記号、文字列の断片など、分割方法に応じた単位になります。
画像なら小領域に分けたパッチ、設備の時系列なら一定区間の計測値を、一つの入力単位として設計できます。ただし、どの単位を採用するかによって、モデルが扱える細かさと計算負荷が変わります。
最初に、入力を表す記号を定義します。ベクトルは行ベクトルとして書きます。
| 記号 | 定義 |
|---|---|
| \(n\) | 一つの入力列に含まれるトークン数。正整数 |
| \(d\) | 各トークンを表す特徴ベクトルの次元。正整数。文献では \(d_{\mathrm{model}}\) とも書く |
| \(i,j\) | 入力位置を表す整数。いずれも \(1\) から \(n\) まで |
| \(x_i\) | 位置 \(i\) の入力特徴を表す、\(d\) 次元の行ベクトル |
| \(X\) | 各 \(x_i\) を第 \(i\) 行として縦に並べた、\(n\times d\) の入力行列 |
以下の \(\mathbb R\) は実数全体、\(\mathbb R^{n\times d}\) は実数を要素に持つ \(n\) 行 \(d\) 列の行列の集合です。したがって、入力の形状は \(X\in\mathbb R^{n\times d}\) と書けます。
文章では、トークンをベクトルに対応付ける埋め込み(Embedding)を使います。位置 \(i\) の内容を表す埋め込みを \(e_i\)、同じ次元の位置ベクトルを \(p_i\) と定義すると、位置情報を加算する方式では、
と入力を作ります。ここでは必要な尺度調整を \(e_i\) に含めています。位置情報の与え方には別の方式もあり、第6節で整理します。
2. Query・Key・Valueの役割
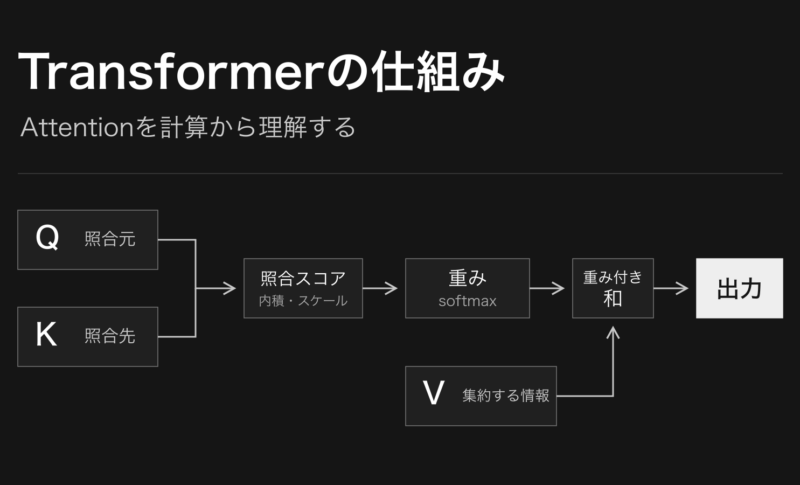
Self-Attentionでは、同じ入力から三種類の表現を作ります。Query(クエリ)は照合する側、Key(キー)は照合される側、Value(バリュー)は計算した重みで集約する情報です。
| 表現 | 計算での役割 |
|---|---|
| Query:\(Q\) | 各位置から、どの位置をどの程度参照するかを計算するための表現 |
| Key:\(K\) | Queryとの内積を計算するための、参照先の表現 |
| Value:\(V\) | 参照の重みに応じて加重和を取る、参照先の情報 |
QueryとKeyの次元を正整数 \(d_k\)、Valueの次元を正整数 \(d_v\) とします。\(W_Q,W_K,W_V\) は、入力をそれぞれの表現に変換する学習可能な重み行列です。形状は、順に \(d\times d_k\)、\(d\times d_k\)、\(d\times d_v\) です。添字の \(Q,K,V\) は対応する役割を示します。
この定義で、三種類の表現を次のように計算します。
\(Q,K\) は \(n\times d_k\)、\(V\) は \(n\times d_v\) の行列になります。\(Q\) の第 \(i\) 行を \(q_i\)、\(K,V\) の第 \(j\) 行をそれぞれ \(k_j,v_j\) と書きます。これらも行ベクトルです。ここでは射影時のバイアスを省略しています。
三つの重み行列は通常、別々に学習します。同じ入力から作るためSelf-Attentionと呼びますが、\(Q,K,V\) が同じ値になるという意味ではありません。また、\(V\) は強化学習の「状態価値」ではなく、ここでは集約対象の特徴を表します。
Queryと各Keyの内積を計算し、尺度を調整する。
スコアをsoftmaxで変換し、参照先ごとの重みを求める。
その重みでValueの加重和を計算し、出力を作る。
3. Attentionの計算式
内積から参照の重みへ
位置 \(i\) から位置 \(j\) への照合スコアを \(s_{ij}\)、正規化後の重みを \(\alpha_{ij}\)、位置 \(i\) の出力を \(z_i\) と定義します。上付きの \(\top\) は転置を表し、行ベクトル同士では \(q_i k_j^\top\) が内積になります。
\(\exp\) は指数関数、\(\sum\) は指定範囲の和です。分母の \(r\) は、参照先を数えるための添字で、\(1\) から \(n\) まで動きます。未来位置などを除外しない基本形は、次の三段階です。
指数関数による正規化がsoftmax(ソフトマックス)です。入力が有限なら各重みは正になり、同じQueryに対する重みの総和は1になります。スコアが大きい参照先ほど、そのValueを大きな重みで集約します。
全位置の重みを並べた行列を \(A\in\mathbb R^{n\times n}\)、出力を並べた行列を \(Z\in\mathbb R^{n\times d_v}\) とします。\(\operatorname{softmax}_{\mathrm{row}}\) は、行ごとにKey方向へsoftmaxを適用する操作です。このAttentionの関数を \(\operatorname{Attention}\) と書くと、
になります。softmaxは行列全体を一括で正規化するのではなく、各Queryに対して、参照先の重みを正規化する操作です。
平方根で割る理由
内積は、対応する成分の積を足し合わせた値です。QueryとKeyの各成分が互いに独立で、平均0・分散1という仮定を置くと、内積の分散は \(d_k\) に比例して増えます。そこで \(\sqrt{d_k}\) で割ると、この仮定のもとで分散を1にそろえられます。
スコアの差が過大になると、softmaxの重みが一部の位置に集中し、勾配が小さくなりやすくなります。この尺度調整がScaled Dot-Product Attentionの「Scaled」に当たります。ただし、学習済みの成分が常に独立・分散1になるという主張ではありません。Vaswaniら(2017)、第3.2.1節
重みの意味と、予測理由の違い
Attentionの重みは、その層・そのheadでValueをどの比率で集約したかを表します。Valueの内容、後段の変換、残差接続も最終出力に影響するため、重みだけから予測への寄与を一意に決めることはできません。
Attention分布と、勾配などから求めた入力の重要度が一致しない事例は、自然言語処理の研究でも報告されています。Jain & Wallace(2019)
製造用途でも、可視化は挙動を調べる手がかりになりますが、それだけで欠陥の原因や設備間の因果関係を特定したとは判断できません。
4. 三つの入力による数値例
一つのQueryから、三つの参照先を集約する例を計算します。\(n=3\)、\(d_k=d_v=2\) とし、位置1のQueryを \(q_1=(1,0)\) に固定します。KeyとValueは次の値を与えます。各成分に温度や品質などの物理的な意味は割り当てていません。
| 参照先 | Key:\(k_j\) | Value:\(v_j\) | スコア:\(s_{1j}\) | 重み:\(\alpha_{1j}\) |
|---|---|---|---|---|
| 位置1 | \((1,0)\) | \((2,0)\) | 約0.7071 | 約0.4011 |
| 位置2 | \((0,1)\) | \((0,2)\) | 0 | 約0.1978 |
| 位置3 | \((1,1)\) | \((2,2)\) | 約0.7071 | 約0.4011 |
位置1と位置3のKeyは、このQueryとの内積が同じなので、同じ重みになります。位置2のスコアは0ですが、softmax後の重みまで0になるわけではありません。ここでは \(\exp(0)=1\) が分子に残ります。
丸める前の重みでValueの加重和を計算すると、位置1の出力は、
です。最大スコアのValueを一つ選ぶ処理ではなく、複数のValueを重みに応じて合成しています。
実際の学習では、出力に対する損失から勾配を計算し、\(W_Q,W_K,W_V\) などを更新します。その結果、タスクに合う照合と情報集約を行うように変換が調整されます。数値例では、その学習過程を省いて一回の計算だけを示しています。
5. Multi-Head Attention
Multi-Head Attention(マルチヘッド注意)は、別々の射影行列を持つAttentionを複数並べる構造です。各headで異なる照合・集約を計算し、その出力を結合します。
head数を正整数 \(h\)、head番号を \(\ell=1,\ldots,h\) とします。説明を簡単にするため、\(d\) は \(h\) で割り切れ、各headでは \(d_k=d_v=d/h\) とします。\(Q_\ell,K_\ell,V_\ell\) は、headごとに異なる射影行列で入力 \(X\) から作った表現、\(Z_\ell\) はそのAttention出力です。
\(\operatorname{Concat}\) を各位置の特徴方向への結合、\(W_O\) を形状 \((h d_v)\times d\) の出力射影行列と定義します。添字 \(O\) はOutputを表します。Multi-Head Attentionの関数を \(\operatorname{MHA}\) と書くと、
です。出力は \(n\times d\) になり、次の層でも同じ特徴次元を使えます。
複数headの出力を単純平均する構造ではありません。また、「このheadは文法、このheadは意味」と人が役割を指定するわけでもありません。学習後に特定の傾向が見つかる場合はありますが、headごとに必ず異なる役割が分担される保証はありません。
6. 位置情報と順序
QueryとKeyの内積だけでは、入力がどの位置に置かれていたかを明示的に表せません。位置情報も、順序に依存するマスクも与えないSelf-Attentionでは、入力の行を並べ替えると、出力も同じように並べ替わります。この性質を順列同変と呼びます。「並べ替えても出力が変わらない」という順列不変とは異なります。
文章の語順や画像内の配置を扱うため、位置に応じた情報を計算に加えます。代表的な方法には、次の違いがあります。
| 方式 | 位置情報の与え方 | 設計上の違い |
|---|---|---|
| 正弦・余弦による位置符号化 | 周期の異なる関数で位置ベクトルを作り、入力に加算する | 原論文で採用した方式。位置ベクトル自体は学習しない |
| 学習可能な絶対位置埋め込み | 各位置のベクトルを学習し、入力に加算する | 学習・運用で扱う位置の範囲を設計する必要がある |
| Rotary Position Embedding:RoPE | 位置に応じてQueryとKeyを回転させる | 内積に相対位置の情報を反映する。入力への単純な加算とは異なる |
RoPEはRoFormerの論文で提案された方法です。位置情報を組み込めることと、学習時より長い入力でも十分な精度を維持できることは別の評価課題です。Suら(2021年初出)
第8節の因果マスクも、参照できる位置を順序に応じて制限します。したがって、位置情報を加えない場合の順列同変性を、そのまま因果マスク付きのモデルに当てはめることはできません。
7. FFN・残差接続・正規化
各位置の特徴を変換するFFN
Transformerのブロックには、Attentionに加えてFeed-Forward Network(FFN)があります。Attentionが位置間で情報を集約するのに対し、FFNは各位置の特徴を非線形に変換します。同じ層の中では、全位置に同じFFNを適用します。
FFNの中間次元を正整数 \(d_{\mathrm{ff}}\)、入力行ベクトルを \(u\in\mathbb R^d\) とします。\(W_1,W_2\) は形状 \(d\times d_{\mathrm{ff}}\)、\(d_{\mathrm{ff}}\times d\) の学習可能な行列、\(b_1,b_2\) は次元 \(d_{\mathrm{ff}}\)、\(d\) のバイアスです。\(\operatorname{ReLU}\) は各成分について0と入力値の大きい方を返す関数です。
原論文のFFNは、
と書けます。\(W_1\) で中間次元へ変換し、非線形関数を適用してから \(W_2\) で元の次元へ戻します。後続モデルでは活性化関数やゲート構造が異なるため、すべてのTransformerがこのFFNを使うわけではありません。
残差接続とLayer Normalization
残差接続は、変換後の表現に入力を加える構造です。入力を保持する加算経路を設け、深いネットワークでの学習を助けます。Layer Normalization(LayerNorm)は、各トークンの特徴方向で平均・分散を計算し、正規化と学習可能な尺度・オフセットの調整を行います。通常の形では、別のトークンや別のサンプルの平均を使いません。
ブロックへの入力を改めて \(X\in\mathbb R^{n\times d}\)、Attention後の中間表現を \(U\)、ブロック出力を \(Y\) とします。\(\operatorname{LN}\) をLayerNormと定義し、行列に対するFFNは行ごとに適用するとします。原論文のEncoderブロックは、Dropoutを省くと、
という順序です。これは残差加算の後に正規化するPost-LNの構造です。後続研究には、AttentionやFFNの前に正規化するPre-LNもあります。正規化の位置によって、初期の勾配や学習の安定性が変わることが調べられています。Xiongら(ICML 2020)
- 入力 → Multi-Head Attention → 入力との残差加算 → LayerNorm
- 中間表現 → FFN → 中間表現との残差加算 → LayerNorm
Attentionだけを繰り返すのではなく、位置間の情報集約、特徴の非線形変換、加算経路、正規化を組み合わせたブロックを積み重ねます。原論文、第3節
8. Encoder・Decoderと因果マスク
三つの構成
原論文のTransformerは、機械翻訳のためのEncoder–Decoder構成でした。Encoderが入力列を表現に変換し、Decoderがその表現と、それまでの出力を使って次の出力を予測します。用途に応じて、一方を中心に使う構成もあります。
| 構成 | 基本的な参照範囲 | 代表例と用途 |
|---|---|---|
| Encoder型 | 通常は入力列の前後を参照する | BERT:文章の表現学習、分類など。ViT:画像パッチの表現学習 |
| Decoder-only型 | 通常は各位置より後の入力を参照しない | GPT-2:それまでのトークンから次のトークンを予測する |
| Encoder–Decoder型 | Encoderは入力列を参照し、Decoderは過去の出力とEncoder出力を参照する | 原論文の機械翻訳など、入力列から出力列への変換 |
BERTは、入力の一部を隠して前後の情報から復元するMasked Language Modelingを事前学習に使いました。一方、GPT-2は自己回帰の言語モデルです。同じTransformer系でも、参照範囲と学習目的が異なります。BERT(NAACL 2019、2018年初出)、GPT-2(2019)
未来の位置を除外する因果マスク
位置 \(i\) の表現で次のトークンを予測するとき、位置 \(i+1\) 以降の入力を参照すると、予測する答えを先に見てしまいます。そこで参照先を現在位置までに制限します。この制限が因果マスク(Causal Mask)です。
マスク行列を \(M\in(\mathbb R\cup\{-\infty\})^{n\times n}\) と定義します。\(-\infty\) は、softmax後の重みを0にするための記法です。現在位置自身は許可し、未来位置を除外する場合は、
と置きます。Attentionの重みを計算する前にマスクを加え、
とします。許可された位置の中で重みの総和が1になります。softmax後に未来位置を単に0にする方法とは、正規化の結果が異なります。この例では、各Queryに少なくとも自分自身を含む一つの許可位置があります。
参照可
参照不可
参照不可
参照可
参照可
参照不可
参照可
参照可
参照可
行がQuery、列がKey。「2 → 1」は、位置2から位置1を参照する意味です。
Self-AttentionとCross-Attention
Encoder–DecoderのDecoderには、Cross-Attention(交差注意)もあります。この場合は、Decoder側の表現からQueryを作り、Encoder出力からKeyとValueを作ります。Query側と参照先の列が異なるため、両者のトークン数も同じである必要はありません。
Decoder-only型という呼称は、独立したEncoderを必ず併用する意味ではありません。GPT-2のような基本構成には、原論文のEncoder出力を参照するCross-Attentionはありません。
9. 言語モデルの学習と生成
次トークン予測の目的関数
自己回帰言語モデルでは、それまでのトークンから次のトークンの確率を予測します。最後のTransformer層の特徴を、語彙の各候補に対応するスコアへ線形変換し、softmaxで確率に変換します。これは、参照先の重みを計算するAttention内のsoftmaxとは、対象が異なります。
正解のトークン数を正整数 \(T\)、正解列を \(u_1,\ldots,u_T\)、位置番号を \(t=1,\ldots,T\) と定義します。\(u_{<t}\) は位置 \(t\) より前のトークン列で、最初の予測に必要な開始記号なども条件に含めます。\(\theta\) はモデルの学習可能なパラメータ全体、\(p_\theta(u_t\mid u_{<t})\) は正解トークンに割り当てる条件付き確率です。縦線 \(\mid\) は条件付き、\(\log\) は自然対数を表します。
一つの系列に対する平均の負の対数尤度を損失 \(\mathcal L(\theta)\) と定義すると、基本的な学習目的は、
です。正解に割り当てる確率が大きいほど、その位置の損失は小さくなります。実際の学習では、多数の系列についてこの損失を計算します。ここではパディングや、学習対象から除外する位置の重みを省いています。
学習時の並列計算と、生成時の逐次計算
学習時には正解列がすでにあります。入力と正解を一位置ずらし、因果マスクを使えば、未来の正解を参照せずに、複数位置の予測と損失を並列に計算できます。正解の過去トークンを入力するこの方式は、Teacher Forcingと呼ばれます。
生成時には、次に入力するトークン自体がまだ確定していません。まず与えられた入力文を処理し、次の候補の確率を求めます。その確率から一つ選び、入力列の末尾へ加えて次を予測します。最大確率の候補を選ぶ方法や、確率に応じてサンプリングする方法があります。
| 段階 | すでに与えられているもの | 計算の進み方 |
|---|---|---|
| 学習 | 正解のトークン列 | 因果マスクと一位置ずらした入出力で、複数位置を並列計算する |
| Prefill | ユーザーが与えた入力文など | 既知の入力列をまとめて処理し、生成を始めるための状態を作る |
| Decode | 入力文と、それまでに選んだ出力 | 通常は次のトークンを一つ選ぶたびに、次の計算へ進む |
Transformerの並列性を、通常の自己回帰生成でも文章全体を一度に確定できるという意味には取れません。学習と生成では、正解列が既知かどうかが異なります。
また、Transformerはネットワーク構造、次トークン予測は学習目的です。指示に従うための追加学習や、回答の好みを反映する選好学習(Preference Learning)は、さらに別の設計です。選好データと報酬学習の関係は、関連記事「Bayesian IRLとは何か」で説明しています。
10. 計算量・KVキャッシュ・FlashAttention
入力が長くなると増える計算
全位置から全位置を参照する密なSelf-Attentionでは、一つのheadのスコア行列に \(n^2\) 個の要素があります。入力長を2倍にすると、この要素数は4倍になります。
例として、4,096トークン、一つのサンプル、一つのheadを考えます。スコア行列は16,777,216要素です。これを1要素2バイトで保持する場合、その行列だけで32MiBになります。MiBは1,048,576バイトを表します。モデル全体のメモリー使用量には、ほかのhead、各層の特徴、重み、学習時の勾配などが加わります。
\(O(\cdot)\) は、入力サイズに応じた計算量の増え方を表す記号です。全headを合わせた特徴次元を \(d\) に保つ標準的な構成では、Attentionのスコア計算とValueの集約は、おおむね \(O(n^2d)\) です。これとは別に、射影やFFNにも計算が必要です。したがって、入力長、特徴次元、層数のどれが処理時間を支配するかは、モデルと実行環境に依存します。
KVキャッシュで省ける処理
因果的なDecoderで生成を進めるとき、過去位置のKeyとValueを層ごとに保存しておく方法がKVキャッシュです。過去位置の表現は未来の出力を参照しないため、同じ接頭辞に対するKeyとValueを再利用できます。
新しい位置では、その位置のQuery・Key・Valueを計算し、保存済みのKeyとValueも使ってAttentionを計算します。過去位置を最初から処理し直す負荷は減りますが、新しいQueryから過去を参照する計算は残ります。また、保存する情報量は、モデル構造を固定すれば入力長に応じて増えます。
FlashAttentionで変わる部分
FlashAttentionは、GPUのメモリー階層を考慮し、計算を小さなブロックに分けて実行する方法です。巨大なAttention行列全体をGPUの主記憶へ保存せずに計算し、メモリー転送と保存量を抑えます。Daoら(2022)
元の密なAttentionを近似せずに計算する方式ですが、全位置の組み合わせを扱う演算の二乗性そのものをなくす手法ではありません。浮動小数点の計算順序が変わるため、別の実装とビット単位で同じ結果になるという意味でもありません。
11. 画像認識と製造データへの応用
Vision Transformerと画像パッチ
Vision Transformer(ViT)は、画像を小さなパッチに分け、各パッチを埋め込みベクトルに変換してTransformer Encoderへ入力する方法です。位置情報も加え、パッチ間の関係を計算します。原論文は画像分類を扱い、大規模な事前学習から別の画像認識タスクへ転移する有効性を示しました。Dosovitskiyら(ICLR 2021、2020年初出)
論文題名の「16×16」は、代表的なパッチサイズを指します。すべてのViTで固定された値ではありません。また、画像分類での結果を、そのまま工業製品の微小欠陥検出や見逃し率の改善へ当てはめることはできません。
現場で決める入力・出力・評価
以下は、製造データに適用するための設計上の考察です。特定の製品の内部構造や、導入済みの性能を示すものではありません。
| 対象 | 入力単位と出力の例 | 検証する条件 |
|---|---|---|
| 外観検査 | 画像パッチから特徴を抽出し、画像の良否や欠陥領域を推定する | 微小欠陥を保持する解像度、照明変動、品種・ロットが変わったときの見逃し・過検出 |
| 品質予測 | 温度・圧力・設備負荷などの時間区間から、後工程の品質を予測する | 計測時刻の整合、品質が確定するまでの遅れ、予測時点で利用できる情報の範囲 |
| 設備状態の監視 | センサーの履歴から異常スコアや将来の状態を求める | 設備ごとの差、欠測、運転条件の変更、誤警報と検出遅れ |
| 技術文書の検索・回答 | マニュアルや作業標準の文章から、関連箇所を検索して回答を作る | 文書の版、アクセス権、回答の根拠、数値・単位の整合 |
画像の小さな傷が重要なら、パッチ分割や画像縮小で傷の情報が失われないかを確認します。Attentionの参照範囲を広げても、入力の時点で欠陥が読み取れなければ、その情報は利用できません。
工程の将来品質を予測する場合は、学習・評価データの分け方も性能を左右します。重複した時間窓や同じロットの近いデータを両方に含めると、未知の期間や別ロットへの性能を過大評価するおそれがあります。予測時点より後に確定する検査結果を入力に混ぜない設計も必要です。
Transformerで特徴を抽出できても、それだけで工程条件の最適化や設備制御まで完了するわけではありません。予測値をどの評価指標に結び付け、どの操作を許可するかを別に定めます。学習に使う入力、達成したい品質・生産性、設備で許される処理時間をそろえ、比較対象となる既存手法と同じ条件で検証することが導入判断の基準になります。
参考文献
本文で参照した原論文と、著者・学会による公開資料です。発表年とプレプリントの初出年が異なる資料は区別しています。
- Vaswani, A. et al.(2017). Attention Is All You Need. NeurIPS.
- Devlin, J. et al.(2019、2018年初出). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL.
- Radford, A. et al.(2019). Language Models are Unsupervised Multitask Learners. GPT-2 technical report.
- Dosovitskiy, A. et al.(2021、2020年初出). An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale. ICLR.
- Su, J. et al.(2021年初出). RoFormer: Enhanced Transformer with Rotary Position Embedding.
- Xiong, R. et al.(2020). On Layer Normalization in the Transformer Architecture. ICML.
- Dao, T. et al.(2022). FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS.
- Jain, S. & Wallace, B. C.(2019). Attention is not Explanation. NAACL.
